Simulador de comportamento em redes sociais
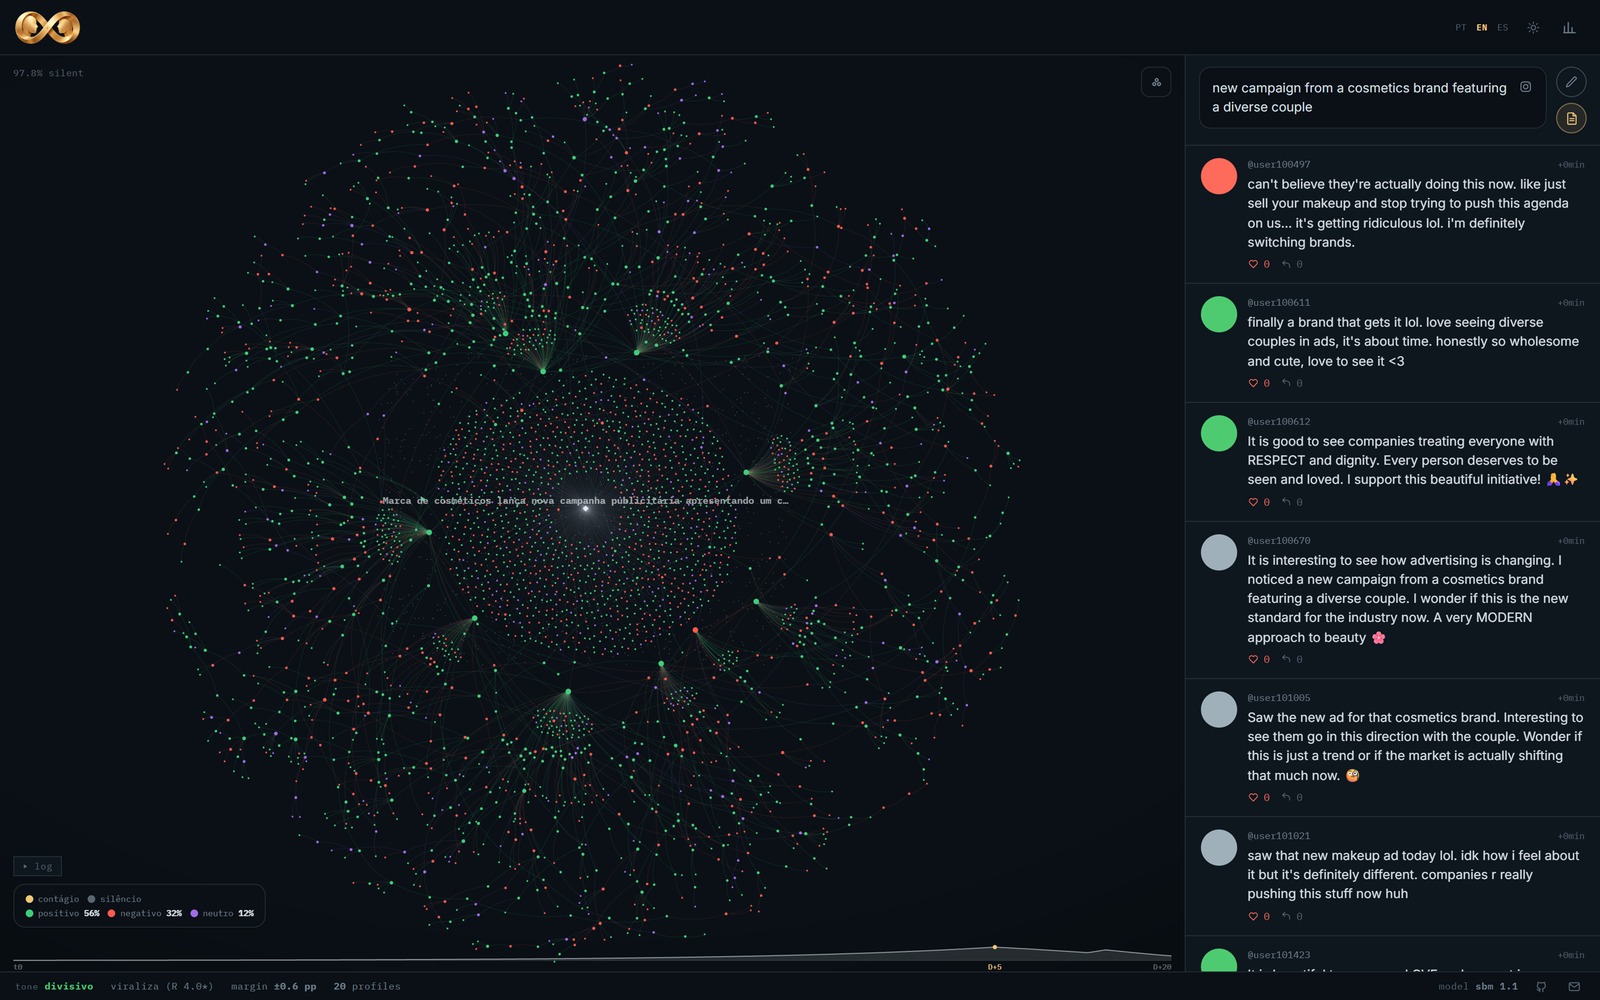
O Parolar é um instrumento de ensaio: você escreve um post, ele mostra a reação provável — quem reage, em que tom, com que alcance e quanto vira silêncio — e te diz na cara quando não sabe. Roda no seu computador, de graça. E as reações não são chute de IA: vêm de um modelo calibrado em dado real (3.352 árvores de discussão, 262 mil comentários).
O que você faz com ele hoje
Tudo gira em torno de um trabalho: ensaiar uma mensagem antes de publicar. Você escreve, escolhe a rede, e a reação se forma na sua frente — no seu computador, de graça. Concretamente, o que já funciona:
- 01Reação provávelApoio, crítica ou neutro, em proporção e com banda de erro.
- 02As reações escritasO texto que as pessoas provavelmente escreveriam — você pega a objeção antes de tomar na cara.
- 03O silêncio medidoQuanto da rede simplesmente ignora — separa “repercutiu” de “teve três respostas”.
- 04Alcance × opiniãoSe espalha muito mas convence pouco, ou o contrário. As duas coisas em separado.
- 05Alerta de tom divisivoQuando o assunto tende a rachar a audiência — um aviso de risco antes da hora.
- 06Fôlego no tempoSe a mensagem tem vida de dias ou é um estouro de minutos.
- 07Comparar A/BDuas versões do post, com pré-registro para a métrica não ser reescrita depois.
- 08Física por plataformaX, Reddit e TikTok reagem diferente — medido. Escolher a rede muda o resultado, e ninguém mais tem isso calibrado.
- 09Laudo + recibo auditávelResultado rápido no alto; grafo, prova e fontes embaixo, para conferir.
- 10ExportarArquivo HTML, PDF com o recibo (precedentes, similaridade, fontes) e JSON — dá para levar a um cliente ou arquivar.
- 11A recusa honestaQuando não há base, ele responde “sem precedente” e o selo de confiança marca frágil. Ele te avisa quando não confiar — é funcionalidade, não defeito.
- 12Roda offline, na CPU, de graçaUm botão, privado, no seu notebook. A MatrAIx precisa das big labs; o Parolar roda no seu computador.
Em copy de marca e consumo — o único terreno com prova dura: +79% de skill sobre a baseline. Uma agência testar duas versões e pegar a objeção antes = valor real, hoje.
Político não — hoje perde para um chute trivial. Não é bola de cristal — dá probabilidade com banda. Fora da bolha (r/brasil) a confiança cai — e ele te avisa quando não sabe.
O Parolar é um instrumento de ensaio: você escreve, ele mostra a reação provável — com o texto das reações, o alcance, o silêncio e o risco — e te diz na cara quando não sabe. Roda no seu computador, de graça.
Para que serve, na prática
O Parolar responde a uma pergunta cara de errar: “se eu publicar isto, o que acontece?” Comunicação, marca e pesquisa usam para ensaiar antes de gastar alcance real.
- AEnsaiar antes de publicarVer a reação provável de uma campanha ou comunicado sem queimar a publicação real.
- BComparar duas versões (A/B)Rodar a mesma ideia em dois textos e ver qual reparte melhor apoio, crítica e silêncio.
- CSeparar alcance de opiniãoUma mensagem pode espalhar muito e convencer pouco. As duas coisas aparecem em separado.
- DLer o que as pessoas escreveriamO texto provável de cada reação antecipa objeções e mal-entendidos que você ainda corrige.
- EMedir o silêncio92% a 99% de uma rede nunca reage. Saber quanto é silêncio separa “repercutiu” de “teve três respostas”.
- FAntecipar tom divisivoO rodapé sinaliza quando um assunto tende a rachar a audiência — risco antes da hora.
O modelo de comportamento
O coração do Parolar aprende como a sociedade age — reação, ação, tempo, prole — e nunca como ela fala. Treinar num texto cru seria imitar a superfície e errar a variância entre grupos. Em vez disso, o comportamento é descrito em três camadas, da mais interpretável à mais cara.
Sobre o que as Leis operam
Cada lei é um deslocamento em log-odds da reação, ancorado num prior global e encolhido pelo N que o sustenta (uma lei só é publicada com ≥8 threads de suporte; peso pleno com 400 comentários). Elas não olham as palavras exatas — olham características do estímulo:
A saída de uma lei é uma distribuição de reação (apoio/crítica/neutro) com retração pelo tamanho da evidência: quanto menor o N, mais a previsão recua para o prior. É o oposto de um chute confiante — a confiança cresce só quando os dados a autorizam.
A matemática da cascata
A propagação não é desenho: é um processo de ramificação (Galton-Watson) com prole medida em árvores reais. Cada reação gera um número aleatório de reações-filhas; como a média fica abaixo de 1, a cascata é subcrítica — cresce, satura e morre. O interesse é medir como ela morre.
A ramificação, de perto
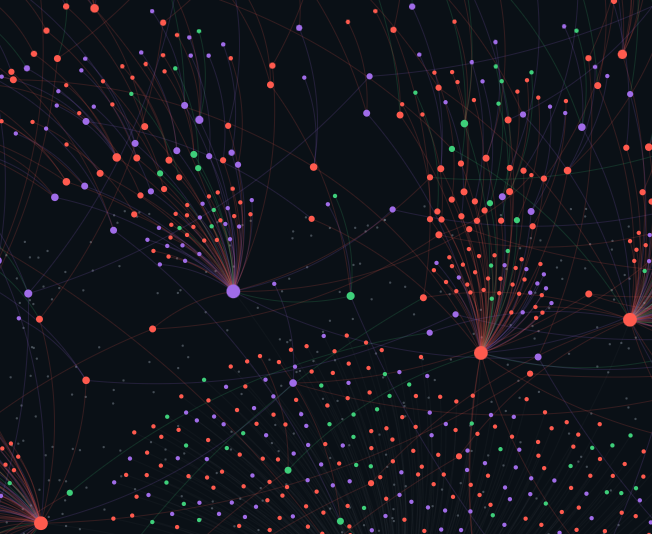
Cada nó-pai lança um leque de filhos — é a prole. Onde muitos filhos pegam, um nó vira sub-hub e o assunto se aprofunda; onde a prole seca, o ramo morre. Ampliado, vê-se cada nó (a cor é o tom da reação) e a aresta que liga cada reação a quem a gerou.
Sobre esse processo, o motor aplica saturação de população finita (a prole encolhe conforme o público exposto-mas-calado seca), um teto de profundidade (Vosoughi 2018) e bandas por Monte Carlo (percentis p5/p95 sobre 400 réplicas). Para multidões grandes, um teorema central do limite declarado soma a prole por aproximação normal — é o que deixa 1 milhão de expostos → ~41 mil comentários caber num piscar de olhos, na CPU.
Galton-Watson
Prole empírica, subcrítica (μ<1). Decide quantas reações cada reação gera.
Attachment · Gómez 2013
φ = α·grau + β·[raiz] + τ^idade. Decide a quem cada reação se liga (α = 0,41, τ = 0,998).
R · Daley-Kendall
R por janela de 12h = filhos ÷ ativos. R ≥ 1 viraliza; R < 1 morre.
As contas, na tela
Nenhuma é opinião — são as equações que o motor roda, com os parâmetros medidos nos dados. Aqui também ficam claros os dois termos técnicos da interface: o R (viralização) e a margem de erro.
Onde os números vêm
Nada aqui é inventado. Cada constante nasce de medição própria em dados reais ou de fonte da literatura (autor, ano, número). O parâmetro que ainda não foi medido entra declarado como provisório.
A topologia depende da plataforma
A mesma frase forma figuras diferentes em cada rede — e isso é medido, não estético. A fração de reações que se liga direto ao post (geração 1) vai de uma estrela quase total no X a uma árvore profunda no Reddit. Por isso escolher a arena é obrigatório: o motor não unifica plataformas às cegas.
O temperamento também
A propensão a criticar é estável por plataforma e não mudou ao dobrar a amostra — outro motivo para a arena ser um parâmetro, não um detalhe. Reddit é o público mais crítico medido; YouTube, o menos.
Testada num corpus 100% não-político nunca visto (r/conversas, 418 threads), a forma da cascata prevista bateu a medida com JSD de 0,003 na distribuição de gerações. A dinâmica generaliza para fora do que foi calibrado.
A evolução temporal — a curva na base
A linha fina no pé do palco não é enfeite: é a vida do assunto no tempo. Ela mostra o volume de reações subindo até um pico e depois caindo — e é o que separa “viralizou” de “morreu em uma hora”.
Na prática: você lê ali se a mensagem tem fôlego de dias ou se é um estouro de minutos. O atraso entre reação e reação foi medido por plataforma — mediana de 28 minutos no Reddit contra quase 2 horas no X — e é o que dá o ritmo dessa curva.
O mesmo grafo, duas leituras
Terminada a rodada, um botão alterna a mesma simulação entre dois arranjos. Cada leitura responde a uma pergunta diferente sobre os mesmos nós. Nada é recalculado — muda o arranjo, não o dado.
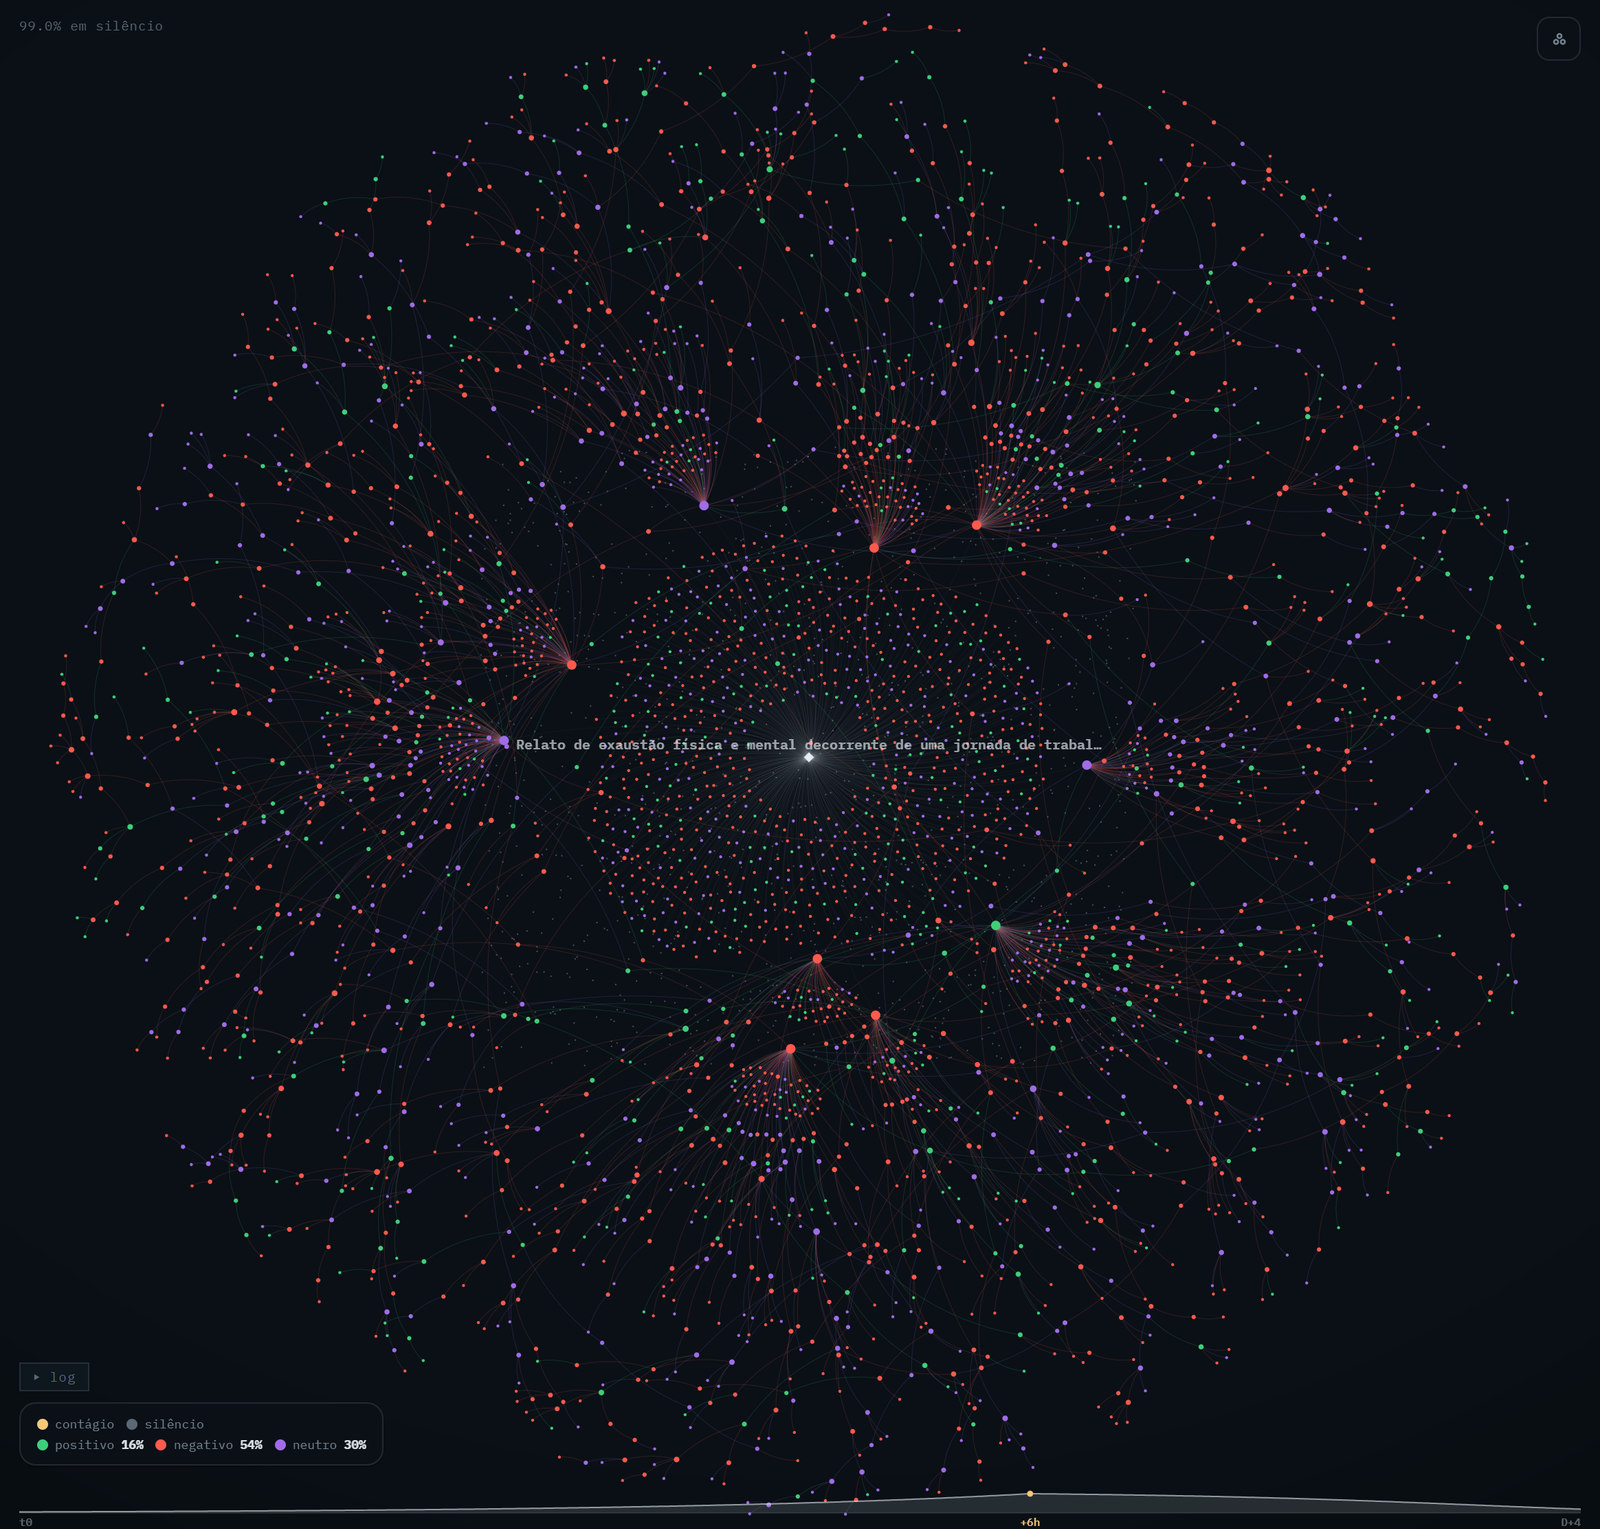
Como se espalhou. Cada nó preso a quem o gerou. Você lê a estrutura: onde a reação ganhou força, quais respostas viraram focos novos, quão fundo desceu.
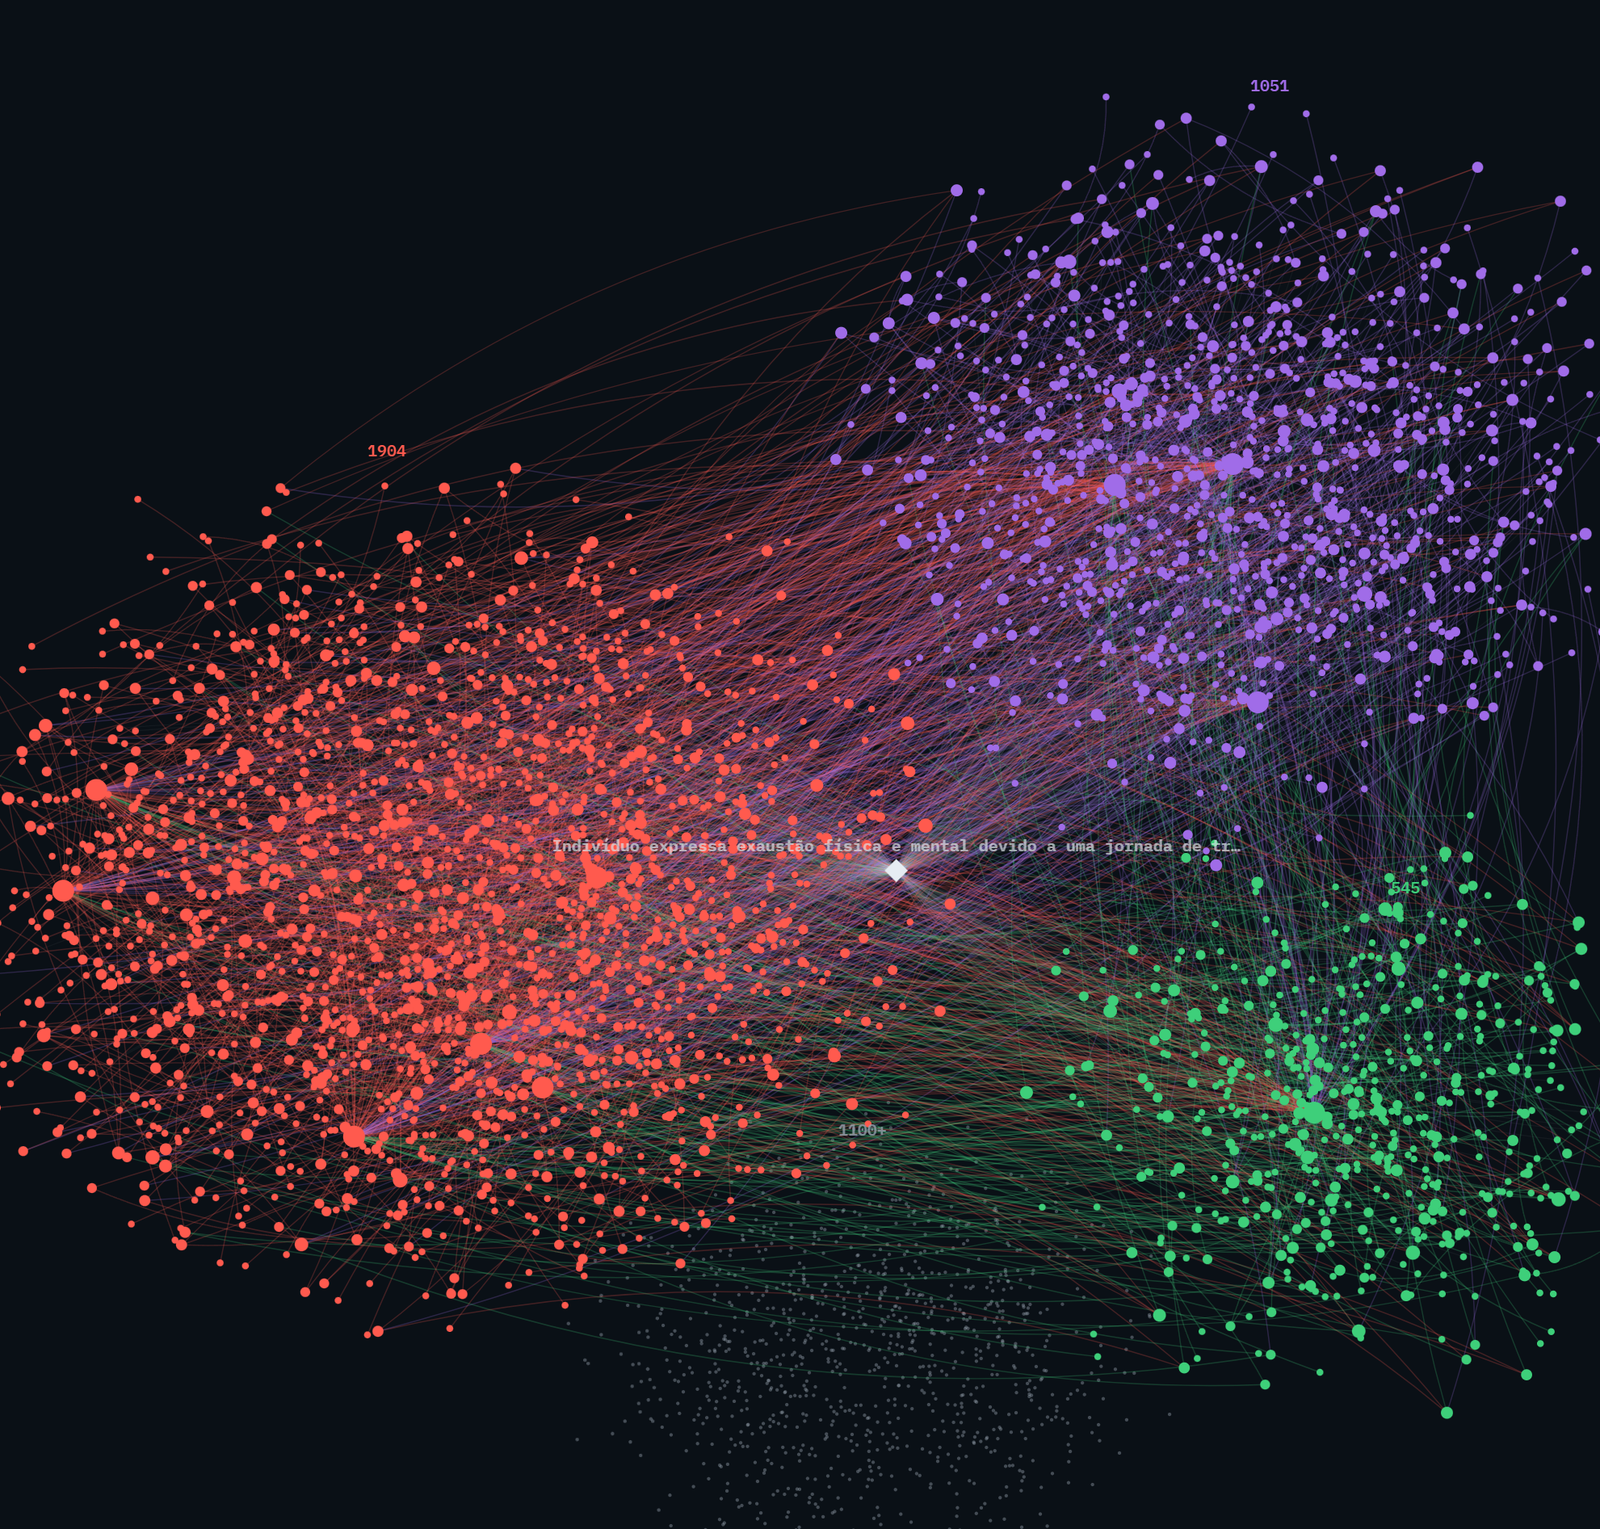
No que deu. Os mesmos nós reorganizados por tom. Você lê o saldo: o tamanho de cada campo e, nos fios que cruzam, quem foi convencido pelo lado oposto.
Como sabemos que os números valem
Enquanto um simulador comum apenas imagina a reação, o Parolar mede o próprio limite e valida cada previsão contra uma baseline honesta — e mostra a conta por inteiro. É essa prestação de contas que dá confiança ao número. Três resultados importam.
1 · O teto do fenômeno
O mesmo texto, mostrado à mesma pessoa em dias diferentes, nem sempre recebe a mesma reação. Medido no próprio dono (150 itens, 3 semanas depois, cego): concordância consigo mesmo de 0,507. Esse é o teto — nenhum classificador honesto o ultrapassa. Um simulador anunciando 0,9 estaria mentindo sobre o problema.
2 · Ganho sobre a baseline, por domínio
Todo relatório do motor carrega, inseparável, uma baseline honesta (a média da biblioteca, sem esperteza) e o ganho sobre ela por domínio. É onde o produto mais brilha — e onde a próxima versão evolui:
O motor decide, com precisão validada, quem reage, quando e por qual caminho — o coração do comportamento. A forma milimétrica da cascata a estatística de base ainda descreve tão bem quanto (n = 77), e a gente diz isso abertamente em vez de fingir que prevê cada detalhe. Transparência é o nosso diferencial, não um defeito.
3 · O gate e o pré-registro
Nenhum modelo novo entra sem passar por um tribunal pré-declarado: a regra é escrita e assinada (sha256) antes de ver os resultados, e o candidato só promove se vencer as Leis e a baseline num teste temporal, em público. Predições do mundo real são registradas com carimbo de tempo e conferidas dois dias depois — o acerto e o erro ficam ambos no placar público. É a mesma disciplina que separa medida de teatro: sem esse crivo, até agentes-LLM caros perdem para um baseline TF-IDF trivial.
Os resultados saem da ferramenta
Toda simulação vira arquivo — para arquivar, comparar, auditar ou levar a um relatório. Nada fica preso na tela. Tudo é gerado no seu navegador, sem servidor e sem link público.
HTML autocontido
Um arquivo com o post testado, o veredito com as margens de erro, os indicadores (tom, alcance projetado, pico, viralização), a curva temporal e o feed de reações. Abre em qualquer navegador.
Duas versões + deltas
Dois vereditos lado a lado, o delta B−A com IC95, a manchete “versão X sai melhor” — e um pré-registro (experimento + sha256) para a métrica não ser reescrita depois.
PDF com o recibo
Imprimível, com os precedentes usados (similaridade, peso, fontes), o nível de confiança, a população sintética e a física de arena medida. O caminho inteiro até o número.
Dados e prova do modelo
Export .json da simulação para reprocessar, e o boletim do modelo (/api/prova) com backtest, retrodição e o placar das predições pré-registradas.
Rodar na sua máquina
Um comando, dois modos. O demo mostra o produto inteiro sem baixar nenhuma IA. O completo sobe o modelo sozinho e libera simular o que quiser — tudo offline, na CPU.
Demo — em 2 minutos
# zero IA, zero download além da imagem
docker compose up

# abra no navegador
http://localhost:8123
Completo — simule o que quiser
# sobe o modelo junto e baixa sozinho
docker compose --profile full up

# 1ª vez baixa o modelo; depois sobe direto
Escolha sua IA
O motor usa um LLM só para dois trabalhos estreitos (ler o estímulo e escrever as vozes). Quatro caminhos, do “só olhar” ao “minha nuvem”:
- ASó quero ver
docker compose up— o demo (replay), zero IA, zero chave, zero setup. - BUsar de verdade, sem instalar IA
docker compose --profile full up— baixa um modelo local sozinho na 1ª vez. Offline, sem chave. - CJá tenho OllamaAponte o
.envpro seu:PAROLAR_LLM_BASE_URL=http://localhost:11434/v1, modelogemma4:e4b. É o padrão. - DPrefiro a nuvemOllama Cloud ou qualquer endpoint OpenAI-compatible: troque as 3 linhas
PAROLAR_LLM_*no.env(URL, chave, modelo).
Escreva e escolha a arena
A arena é obrigatória — cada plataforma tem topologia, temperamento e física próprios.
Assista à cascata
O grafo cresce ao vivo, com banda de incerteza; a curva no pé mostra o assunto subir e morrer.
Leia o laudo — ou desça e audite
Resultado rápido no alto; grafo, prova e recibo embaixo, para conferir cada número.
Extraia e atualize
Exporte HTML, A/B, PDF ou JSON. Atualizar troca o motor e preserva o que a sua instância aprendeu.
Código aberto, por método
Um instrumento de medida que não se pode inspecionar é um oráculo. O Parolar é aberto porque a única forma de confiar num número é abrir a máquina que o produziu, contestar o mecanismo e ver as falhas ao lado dos acertos. O modelo é publicado à parte, sob licença aberta, sem dado bruto.